

一份寫得很漂亮的品管圈結案報告攤在螢幕上。品管圈是醫院裡最常見的改善單位:幾個一線同仁組成一個小組,用固定的十個步驟跑完一輪改善,最後交一份結案報告。用你的話講,就是一次小型改善專案的 postmortem 加 action plan,格式是全院統一的。
我翻到第五步驟「要因分析」的最後一行:
經查檢表回收與現場觀察驗證,確認真因為交班欄位不足、新進人員訓練不足。
我把它改成:
經圈員討論,確認真因為交班欄位不足、新進人員訓練不足。
改動十幾個字。其他地方一個字沒動——魚骨圖還在、對策評價矩陣還在、效果確認的前後數據還在、標準化的查核表還在。從外觀上看,這兩份報告一樣完整、一樣厚、一樣好看。
如果這是一個 commit,它的 diff 只有一行。
但在方法論上,它們差了一整級。原版說的是「驗證過的真因」,改過的版本說的是「大家覺得應該是的原因」。而後面所有的對策、所有的資源、所有那些同仁真的照著做了三個月的事情,全部架在一個沒有被驗證過的猜測上。
我把兩個版本一起丟進那套正在測試的評分系統。
然後坐在螢幕前等一件事:它會不會發現我動了手腳。
這個下午後來變成一整套方法。今天要講的就是它。
Day 19 我花了一整篇論證「AI 說它有 92% 準確率」為什麼是一句沒有意義的話,那篇留下的問題是:當這件事根本沒有標準答案,你到底要驗證什麼? 今天不重複那個論證,今天講我實際採用的解法。
先講清楚為什麼這個任務沒有標準答案可以對。
品管圈報告的「品質」不是文字漂不漂亮,是方法論站不站得住。要因分析有沒有做驗證、對策有沒有對應到驗證出來的真因、效果確認的前後數據可不可以比、有沒有標準化——這些是有專業共識的判準,不是主觀好惡。
但院內歷年那幾百份報告,我們手上只有分數,沒有標註。當年的評分表寫的是「這圈得幾分」,沒有寫「這份報告哪一步壞了、壞在哪一行」。而評分系統要學的、要被驗證的,正好是後面那件事。
那回頭補標不行嗎?可以,但你會立刻撞上兩件事。第一是量:認真標一份報告要一個小時起跳,而且標的人得是懂方法論的人,那正好是院內最忙的那幾個。第二比較麻煩——找誰標?Day 20 談過,三個資深評審看同一份報告,分數本來就會差。所以你補出來的不是標準答案,是某一位委員在某一天的判斷。把它當成真理拿去量 AI,等於用一支沒校準的尺去驗另一支尺。
你那邊也有同一個處境:一個沒有 golden set 的任務,你能跑的 regression 只剩「跟上一版比」——而上一版也沒有人驗過。兩版一致,只代表它穩定地做著同一件可能是錯的事。
於是這個任務卡在一個很尷尬的位置:我要驗證一套判斷系統,但我沒有任何一份可以拿來對答案的資料。
轉折在那個下午發生。我不是沒有標準答案,我是不能撿到標準答案。
但我可以製造它。
這件事你們早就在做,只是不叫這個名字。
第一個對照是 fault injection。你不會等機房真的斷電才知道 failover 行不行,你自己去拔那條電源線——因為只有自己拔的時候,你才知道正確答案該長什麼樣。監控系統的驗證方式,從來就是製造一個你已經知道答案的故障。
第二個對照更貼,貼到我第一次聽到的時候愣了一下——mutation testing。
它的邏輯是這樣的:你的測試套件跑起來全綠。但全綠代表測試寫得好,還是代表測試根本沒在測東西?分不出來。所以做法是反過來:去把被測的程式故意改壞——把 > 改成 >=、把回傳值換成 null、把一個條件分支刪掉——然後看測試會不會紅。會紅,這個 mutant 被殺掉了,代表那條測試有價值。還是全綠,那條測試就是裝飾品。
mutation testing 殺不掉的 mutant,就是你的測試盲區。
第三個對照比前兩個都老,老到它根本不在軟體業——破壞性試驗。要知道一個接頭夠不夠牢,不是等它在客戶手上斷掉,是自己拿去拉到斷為止。你要的從來不是「它現在好不好」,是**「它從哪裡開始壞」**。
而醫院其實也一直在做同一件事,只是沒有把它當成驗證方法:演習。消防演習、大量傷患演練、心跳停止的情境模擬——都是自己製造一次已知的壞掉,然後看通報與應變的鏈路接不接得起來。病安小組每年都在做,只是沒有人說那是在驗證偵測能力。
四個領域、四個名字,同一個動作:先製造一個你已經知道答案的壞掉,再看你的偵測機制認不認得它。
我那天下午做的是完全同一件事。只是被測的不是測試套件,是一套 AI 評分系統;被改壞的不是程式,是一份報告。
這套東西後來有了個名字,叫陷阱池。
隨手改壞幾份報告不叫方法,那叫玩。要能拿來當驗證工具,有幾件事必須先做對。
第一,陷阱要有編號。 每一種缺陷是一個有 ID 的物件,不是一團「一些問題」。每個編號要定義:這是哪一類方法論缺陷、嚴重度是什麼、它應該影響評分的哪幾個維度。像 lint rule 有 rule ID 一樣。沒有編號,你只能說「它抓到了三成」;有編號,你才能說「它對某一類缺陷幾乎全中,對另一類幾乎全漏」——後面這句才有行動價值。
舉幾個編號長什麼樣子(型態為示意,實際條目與嚴重度分級另行發表):
| 陷阱型態 | 說明 | 嚴重度 |
|---|---|---|
| 要因驗證缺漏 | 選定了要因,但沒有做驗證就直接進對策 | 高 |
| 對策與真因不對應 | 對策打的不是驗證出來的那個原因 | 高 |
| 前後數據不可比 | 改善前後的分母不同、時間區間不同 | 高 |
| 目標設定無依據 | 目標值沒有任何參考基準 | 中 |
| 標準化步驟缺漏 | 改善有效,但沒有寫成 SOP 或查核表 | 中 |
| 無形成果誇大 | 宣稱的成果對應不到實際做過的事 | 低 |
第二,每一份案例要配一張 manifest。 這份報告植入了哪幾個陷阱、植入在哪一個步驟、預期偵測難度是高是低。這張 manifest 就是 ground truth。
這是整個方法的關鍵,值得單獨講一句:
因為缺陷是我放的,所以標準答案不是被發現的,是被建構的。
它跟撿來的標註有一個本質差別。撿來的標註,你永遠不確定「這裡沒有標」是因為沒問題,還是因為標的人漏了。建構出來的標註沒有這個問題——我知道我放了什麼,也知道我沒放什麼。漏報跟誤報第一次可以乾淨地分開。
第三,嚴重度要分層,難度要分層。 如果所有陷阱都是一眼看得出來的,你量到的不是系統的偵測能力,是題目太簡單。所以池子裡要有明顯的、要有中等的,也要有埋在一句話裡的——就像那句「經圈員討論」。系統在哪個難度層開始漏,那條線就是它目前的能力邊界。
第四,要有乾淨的對照組。 池子裡必須有沒有植入嚴重缺陷的報告。這件事聽起來多餘,其實是整個設計的地基:**如果每一份都有問題,那系統只要每份都喊「有問題」就能拿滿分。**那就像一個永遠回傳 true 的 test——它從來不會紅,所以它從來沒有在測任何東西。 對照組是唯一能戳破這種作弊的東西,它同時也是後天那篇的引信,先記著。
第五,分佈要對得上真實世界。 我最想抓的是「對策跟真因對不上」,所以第一版池子裡這種陷阱特別多。這是錯的:池子的組成會直接決定你量出來的數字,如果它只反映我的偏好,我量到的就只是「系統符不符合我的偏好」。主題別、嚴重度、缺陷型態的比例,都要往真實報告的分佈靠。
第六,造題的模型不能是評分的模型。 這句話後面藏著一整篇的份量,明天整篇談。
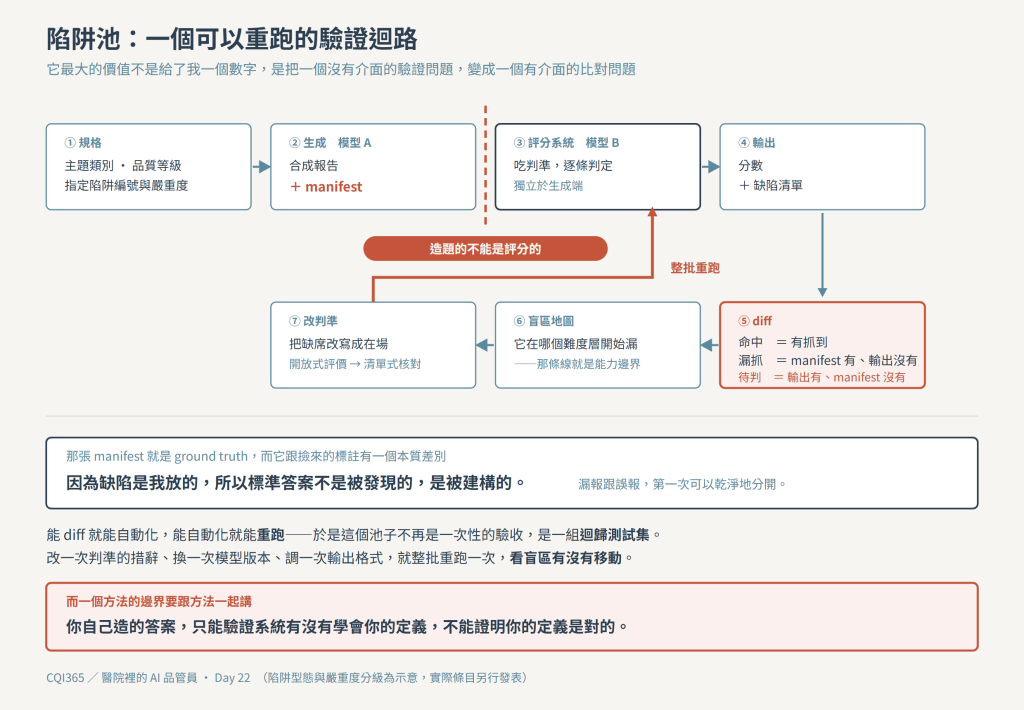
陷阱池最大的價值不在於它給了我一個數字,而在於它把一個沒有介面的驗證問題,變成一個有介面的比對問題。
評分系統的輸出本來是一段話:分數、理由、它認為有哪些缺陷。這種輸出你只能用讀的,讀完憑感覺說「還不錯」。有了 manifest 之後,輸出的另一端多了一個可以 diff 的對象:
系統輸出的缺陷清單  ⟷  manifest 上的陷阱清單
     命中          = 有抓到
     manifest 有、輸出沒有  = 漏抓
     輸出有、manifest 沒有  = 待判(可能是誤判,也可能是我沒設計的真問題)
能 diff,就能自動化。能自動化,就能重跑。
於是這個池子不再是一次性的驗收,而是一組迴歸測試集。改一次判準的措辭、換一次模型版本、調一次輸出格式,就整批重跑一次,看盲區有沒有移動。這正是 Day 1 說的那件事:從一次性問答,變成可重跑、可驗證、可監測的流程。
第一版的分析我只問一個問題:它有沒有抓到?後來發現這個問題問得太粗,必須拆成兩個。
一開始我以為這兩件事會一起發生。它們不會。而且分開的那兩種型態,意義完全不同:
分數掉了,但講不出理由。 它感覺到這份報告不對勁,可是說不出哪裡不對。這種輸出在品管流程裡是不能用的。Day 1 講過我這份工作的重量在於「說得出理由」——當單位問「憑什麼說我們這份不合格」,我不能回答「系統覺得不太好」。一個給得出分數但給不出理由的評分器,在這個場景等於沒有。
理由講得頭頭是道,但分數沒掉。 它在文字裡清清楚楚寫了「本案要因未見驗證程序」,然後那個維度給了一個很體面的分數。這種更危險,因為它看起來特別懂。人讀到那段理由就信了,不會回頭去看分數對不對。
用你們的話說,前者是 test fail 了但 assertion message 沒告訴你哪裡錯;後者是 log 裡印了一整排 ERROR,exit code 卻是 0。
所以評分系統的輸出必須被當成兩個要互相檢核的欄位,而不是一個分數加一段裝飾文字。這是陷阱池逼出來的設計決策,不是我一開始想得到的。
陷阱池真正的產出不是命中率,是盲區地圖。跑下來看到的東西,讓我把幾個原本模糊的抱怨變成了具體的失效型態。
一、單點缺陷會擴散成整體印象。
陷阱植在「要因分析」,系統把「對策研擬」「效果確認」的分數也一起拉了下來。它答對了大方向——這份報告確實有問題——但定位錯了。方向是穩定的:它傾向把一個局部缺陷,擴散成一種整體印象。
這在品管流程裡代價很高。稽核回饋給圈員的時候,要講的是「你第五步這裡少了驗證,補上就好」,不是「你這份寫得不太行」。前者可以行動,後者只會讓人不想再做圈。用你們的話講,就是一個 test failure 讓整個 suite 都紅了,你不知道 root cause 在哪一行。
二、它擅長評價你寫了什麼,不擅長發現你沒寫什麼。
這是最讓我意外的一項,也是陷阱池最有價值的一次發現。
報告寫得長、格式齊、圖表多、名詞用得專業,分數就高,即使方法論是破的。反過來,一份樸素但方法論扎實的報告,分數會被低估。
原因不難理解,但要有陷阱池才看得見:我植入的缺陷絕大多數是缺席型的——少了一步驗證、少了一份 SOP、少了一個基準。而模型對「有東西」的敏感度遠高於對「少東西」的敏感度。你給它一段文字,它評的就是這段文字,不會自動去想「這裡照理說還應該有一段」。
它擅長評價你寫了什麼,不擅長發現你沒寫什麼。
這句話對做 code review 的人應該不陌生。AI reviewer 很會挑你寫出來的那行有什麼問題,很少會告訴你「這個函式少了錯誤處理」「這個 migration 沒有 rollback」。同一種偏誤,換了一個領域。
處理方式不是換模型,是把缺席改寫成在場:判準不要寫成「評估要因分析的嚴謹度」,要寫成「逐項確認以下六件事是否存在,不存在請明確列出」。把開放式評價改成清單式核對,缺席就變成一個可以被勾選的欄位。判準怎麼寫成可判定的敘述,Day 21 談過,這裡是它的一個具體應用場合。
三、它抓到的,不在我的名單上。
系統列出一個缺陷,manifest 上沒有這一項。這時候只有兩種可能:它幻覺了,或者它真的看到了一個我沒設計進去的問題。
而這兩種可能,在資料上長得一模一樣。
這是陷阱池方法最誠實的軟肋。我後來的處理是把這一類單獨標成「探索性發現」,不計入命中率也不計入誤判率,全部丟回人審。這一欄有時候比命中率那一欄有用——它偶爾會指出我寫判準時沒想到的角度。但它也可能整段是編的,分辨的成本只能由人付。
一個方法的邊界要跟方法一起講,所以這段不能省。
第一,陷阱池的 ground truth 是設計標籤,不是專家共識。 我知道我放了什麼,但我不知道三位資深委員會不會同意「這確實構成缺陷」、以及嚴重度是不是我標的那一級。所以陷阱池能回答的問題是:「這套系統抓不抓得到我定義的缺陷?」它不能回答:「這套系統的判斷跟專家一不一致?」後面這個問題只能靠專家盲審回答,那是另一條完全獨立的驗證路線。
把這兩件事混為一談,是我看過最常見的誤用。你自己造的答案,只能驗證系統有沒有學會你的定義,不能證明你的定義是對的。
第二,自己造的報告可能太乾淨。 AI 生成的報告帶著模型自己的寫作腔調,句式整齊、結構工整、用詞一致。真實的圈報告不是這樣——有的段落突然跳掉,有的表格對不上內文,有的通篇是條列。如果池子裡全部是自己造的,我就是在自己跟自己玩:系統在自己造的報告上表現好,可能只代表它熟悉這種文體。
所以池子裡必須摻進真實的報告當作分佈的錨。院內的不能用(紅線),但公開期刊上有一批已發表的品管圈論文,授權允許重用,那些是真人寫的。自己造的跟真實的一起跑,比對兩邊的分數分佈落不落在同一個區間——如果差很多,那不是系統的問題,是我的池子造歪了。
第三,這正是 mutation testing 的老問題。 你造出來的 mutant,代不代表真實 bug 的分佈?equivalent mutant 怎麼辦?這個問題在軟體工程界吵了幾十年沒有結論,我不會在醫院裡把它解決掉。我能做的只是把限制寫在方法裡,而不是假裝它不存在。


 iThome鐵人賽
 看影片追技術